第一章 搜索引擎与ElasticSearch v1.0
搜索引擎(英文名:search engine),是根据用户需求与一定算法,运用特定策略从互联网检索出指定信息反馈给用户的一门检索技术。搜索引擎依托于多种技术,如网络爬虫技术、检索排序技术、网页处理技术、大数据处理技术、自然语言处理技术等,为信息检索用户提供快速、高相关性的信息服务。搜索引擎技术的核心模块一般包括爬虫、索引、检索和排序等,同时可添加其他一系列辅助模块,以为用户创造更好的网络使用环境。
简单来说,搜索引擎就是帮你从海量数据中快速找到你想要的东西
一、正排索引与倒排索引
1、正排索引
特点
便于快速获取某篇文档的完整内容,但无法高效响应 "包含某关键词的文档有哪些" 这类查询(需遍历所有文档逐一匹配,效率极低)。
类似结构如下:
| id | title | price | detail |
|---|---|---|---|
| 1 | 小米手机 | 3499 | xxx |
| 2 | 华为手机 | 4999 | xxx |
2、倒排索引
①核心结构
倒排索引由 "词项词典" 和 "倒排列表" 组成:
- 词项词典:存储所有去重后的词项(如 "搜索引擎""倒排索引"),并指向对应的倒排列表。
- 倒排列表:记录包含该词项的文档 ID、词频(出现次数)、位置等信息。
②特点
能直接定位包含目标词项的所有文档,将 "遍历文档找词" 转化为 "通过词找文档",大幅提升检索效率,是现代搜索引擎的标配索引结构。
类似结构如下:
| token | doc id |
|---|---|
| 小米 | 1 |
| 手机 | 1,2 |
| 华为 | 2 |
二、文本权重算法
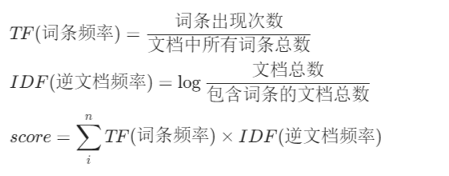
1、TF-IDF(ES 5.x 及过往版本默认算法)
①原理
- 词频(TF):词在单篇文档中的出现频率(归一化减小文档长度影响)
- 逆文档频率(IDF):词在语料库中的稀缺性(稀缺词 IDF 值更高)
- 得分计算:
②优缺点
- 优点:原理简单、计算高效,适合大规模语料快速处理。
- 缺点:无词频饱和效应(词频过高时权重无限制增长)、文档长度归一化粗糙(可能低估长文档中核心词的重要性)。
2、BM25(ES 6.0 及更高版本默认算法)
①原理
对于查询词
②关键优化
- 词频饱和:通过
(默认 1.2)控制词频增长的边际效益递减,避免词频过高时分数无限制升高。 - 文档长度自适应:通过
(默认 0.75)和 (文档长度 / 平均长度)调节,平衡长文档与短文档的权重合理性。 - IDF 计算:采用平滑公式
( 为总文档数, 为含词 的文档数)。
③优缺点
- 优点:排序效果大多数场景下优于 TF-IDF,参数可调适配不同场景(如短文本调小
,长文本调大 )。 - 缺点:计算复杂度高于 TF-IDF,依赖参数调优(默认
、 可覆盖多数场景)。
[搜索引擎查询原理示例(Python)]
python
import math
import jieba


class Demo:
    def __init__(self):
        self.reverse_index_dict = dict()  #倒排索引,Map类型,{词条:文档id列表}
        self.document_dict = dict()  #索引,Map类型,{文档id:文档}

    def do_reverse_index(self, document: str):
        word_list = list(jieba.cut(document))  #分词
        this_document_id = len(self.document_dict) + 1
        self.document_dict[this_document_id] = document  #插入新文档
        for word in word_list:
            if self.reverse_index_dict.get(word) is None:
                self.reverse_index_dict[word] = set()
            self.reverse_index_dict[word].add(this_document_id)

    #计算TF-IDF
    def calculate_tfidf(self, word, document):
        #计算词频(TermFrequency)
        def calculate_tf(word, document):
            total_words = list(jieba.cut(document))
            tf = list(total_words).count(word) / len(total_words)
            return tf

        #计算逆文档频率(InverseDocumentFrequency)
        def calculate_idf(word, documents, documents_dict):
            s = documents.get(word)
            if s is None:
                return 0
            return math.log(len(documents_dict) / (len(s) + 1), math.e)

        tf = calculate_tf(word, document)
        idf = calculate_idf(word, self.reverse_index_dict, self.document_dict)
        tfidf = tf * idf
        return tfidf

    def search(self, search_words):
        result = dict()
        word_score = {word: self.calculate_tfidf(word, search_words) for word in demo.reverse_index_dict.keys()}
        for word, score in word_score.items():
            if score > 0:
                for find_id in self.reverse_index_dict[word]:
                    w = self.document_dict.get(find_id)
                    if result.get(w):
                        result[w] = result[w] + score
                    else:
                        result[w] = score
        return sorted(result.items(), key=lambda x: x[1], reverse=True)

demo = Demo()
document_list = ["iphone14手机", "iphone13手机", "华为手机", "小米手机", "华为电脑", "VIVO手机", "OPPO手机","联想拯救者电脑", "Macbook air", "戴尔笔记本电脑", "电脑显示屏", "手机支架"]
for document in document_list:
    demo.do_reverse_index(document)
print(demo.document_dict, demo.reverse_index_dict)
print(demo.search("华为手机"))
搜索引擎涉及多种技术,主要包括:
- 网络爬虫:自动抓取网页内容
- 分词器:将文本切分成词项
- 索引器:构建倒排索引
- 排序算法:计算文档相关性得分
- 缓存机制:提升查询性能
Elasticsearch 是一个基于 Lucene 的开源搜索引擎,具有以下特点:
- 分布式:支持横向扩展,可以处理PB级数据
- 近实时:索引后几乎立即可搜索
- RESTful API:使用简单,易于集成
- 多语言支持:提供 Java、Python、Go 等多种客户端
一、Elasticsearch 核心概念
| 概念 | 说明 | 类比关系型数据库 |
|---|---|---|
| Index | 索引,一类文档的集合 | Database |
| Type | 类型(7.x 后已废弃) | Table |
| Document | 文档,一条数据记录 | Row |
| Field | 字段,文档中的属性 | Column |
| Shard | 分片,索引的水平拆分 | - |
| Replica | 副本,分片的备份 | - |
二、安装与配置
bash
docker run -d \
  --name elasticsearch \
  -p 9200:9200 \
  -p 9300:9300 \
  -e "discovery.type=single-node" \
  -e "xpack.security.enabled=false" \
  elasticsearch:8.11.0
bash
curl http://localhost:9200三、基本使用
python
from elasticsearch import Elasticsearch

# 连接ES
es = Elasticsearch(["http://localhost:9200"])

# 创建索引
es.indices.create(index="my_index", ignore=400)

# 插入文档
doc = {
    "title": "Elasticsearch入门",
    "content": "这是一个搜索引擎教程",
    "timestamp": "2026-01-25"
}
es.index(index="my_index", id=1, document=doc)

# 搜索文档
result = es.search(index="my_index", body={
    "query": {
        "match": {
            "content": "搜索引擎"
        }
    }
})

for hit in result["hits"]["hits"]:
    print(hit["_source"]["title"])