第三章 DSL基本操作 v1.0
一、索引库的创建
1.mapper属性
type:字段数据类型,常见简单类型有以下几种
字符串:text(可分词的文本)、keyword(精确关键词,如:国家、品牌等)
数值:long、integer、short、byte、double、float
布尔:boolean
日期:date
对象:object
地理坐标:geo_point(经纬度确定的点)、geo_shape(多个经纬度确定的区域)
index:是否创建倒排索引,默认true(若不创建倒排索引则不可以参与搜索)
analyzer:使用哪种分词器,值为分词器的名称
properties:字段的子字段
copy_to:将字段拷贝到指定字段(用于提升搜索性能)
{
  "all": {
    "type": "text" ,
    "analyzer": "ik_max_word"
  },
  "brand": {
    "type": "keyword",
    "copy_to": "all"  #复制到all字段,让all字段可以根据brand结果被查询
  }
}
注:id应设置为keyword类型,且因要参与查询,index应当默认为true
2.创建索引库
PUT /索引库名称
{
  "mappings": {
    "properties": {
      "字段名1": {
        "type": "text",
        "analyzer": "ik_smart"
      },
      "字段名2": {
        "type": "keyword",
        "index": "false"
      },
      "字段名3": {
        "porperties":{
          "子字段名": {
            #...
          }
        }
      },
      #...
    }
  }
}
3.查询索引库
GET /索引库名4.删除索引库
DELETE /索引库名5.修改索引库
索引库和mapping一旦创建无法修改,但是可以添加新的字段
PUT /索引库名/_mapping
{
  "perperties": {
    "新字段名" :{
      "type": "integer"
    }
  }
}
6.其他操作
#查询所有索引库
GET /_cat/indices
1.新增文档
POST /索引库名/_doc/文档id
{
  "字段1": "value1",
  "字段2": "value2",
  "字段3": {
    "子属性1": "value3",
    "子属性2": "value4"
  }
}
2.查询文档
GET /索引库名/_doc/文档id3.删除文档
DELETE /索引库名/_doc/文档id4.修改文档
a.全量修改
若文档存在,则覆写原有文档生成新的文档;若文档不存在,则新增文档
PUT /索引库名/_doc/文档id
{
  "字段1": "value1",
  "字段2": "value2",
  "字段3": {
    "子属性1": "value3",
    "子属性2": "value4"
  }
}
b.增量修改
只修改指定的字段值
POST /索引库名/_update/文档id
{
  "doc": {  #此为固定写法
    "字段名": "新值"
  }
}
一、基本查询
1.查询分类
- 查询所有:查询出所有数据,一般测试使用,如:
match_all - 全文检索查询:利用分词器对用户输入内容分词,在倒排索引库中匹配
如:match_query、multi_match_query
- 精确查询:根据精切词条查找数据,一般查找keyword、数值、日期、boolean等类型字段
如:ids、range、term
- 地理查询:根据经纬度查询
如:geo_distance、geo_bounding_box
- 复合查询:将上述各种查询条件组合起来,合并查询条件进行查询
如:bool、function_score
2.基本查询语法
GET /indexName/_search
{
  "query": {
    "查询类型": {
      "查询条件": "查询值"
    }
  }
}
二、DSL查询简单语法
1.查询所有
GET /indexName/_search
{
  "query": {
    "match_all": {}
  }
}
2.全文检索查询
GET /indexName/_search
{
  "query": {
    "match": {
      "FIELD": "TEXT"  #查询字段与检索词
    }
  }
}GET /indexName/_search
{
"query": {
"multi_match": {
"query": "TEXT",
"fields": ["FIELD1","FIELD2", ...] #字段
}
}
}3.精确查询
GET /indexName/_search
{
  "query": {
    "term": {
      "FIELD": {  #字段
        "value": "VALUE"  #查找值
      }
    }
  }
}#需要字段中同时存在所有检索值才能检索到结果
GET /indexName/_search
{
"query": {
"terms": {
"FIELD": ["FIELD1","FIELD2", ...] #查询字段与检索词
}
}
}GET /indexName/_search
{
"query": {
"range": {
"FIELD": { #字段
"gte": 10, #大于等于10,大于为gt
"lte": 20 #小于等于20,小于为lt
}
}
}
}4.地理查询
#查询geo_point值落在某个矩形范围内的所有文档
GET /indexName/_search
{
  "query": {
    "geo_bounding_box": {
      "FIELD": {  #字段
        "top_left": {  #左上坐标
          "lat": 31.1,
          "lon": 121.5
        },
        "bottom_right": {  #右下坐标
          "lat": 30.9,
          "lon": 121.7
        }
      }
    }
  }
}#查询geo_point值到指定中心点小于某个距离值的所有文档
GET /indexName/_search
{
"query": {
"geo_distance": {
"distance": "10km", #指定距中心店距离
"FIELD": "10.00,120.00" #指定经纬度坐标中心点
}
}
}三、复合查询
1.ES分数关联度打分
当我们利用match查询时,文档结果会根据与搜索词条的关联度打分(_score) , 返回结果时按照分值降序排列。
TF-IDF算法(ES5.0前使用)
(TF(词条频率)=\frac{词条出现次数})
(IDF(逆文档频率)=\log{\frac{文档总数}{包含词条的文档总数}})
(score=\sum^n_iTF(词条频率)\times IDF(逆文档频率))
BM25算法(ES5.0后使用)
(Score(Q,d)=\sum^n_i\log(1+\frac{N-n+0.5}{n+0.5})·\frac{f_i}{f_i+k_i·(1-b+b·\frac{dl}{avg dl})})
TF-IDF算法与BM25算法对比
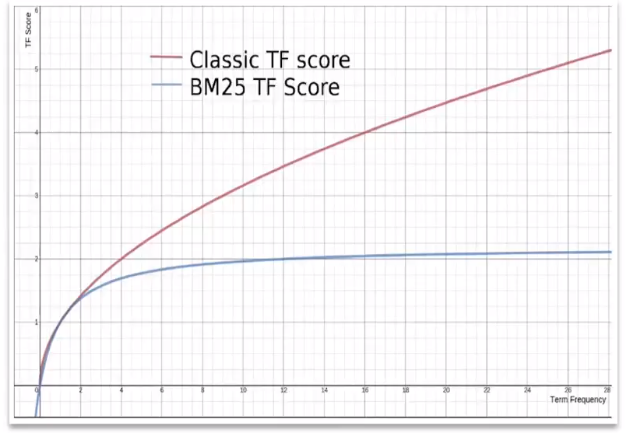
BM25算法降低了TF在过大时的权重,避免词频对查询影响过大
2.算分函数查询
GET /indexName/_search
{
  "query": {
    "function_score": {
      "query": {"match": {"all": "外滩"}},  #原始查询条件
      "functions": [{
          "filter": {"term": {"id": "1"}},  #过滤条件,符合条件的文档才会被重新算分
          "weight": 10  #算分函数
        }],
      "boost_mode": "multiply"  #加权模式
    }
  }
}
[算分函数]
weight:给一个常量值,作为函数结果
feild_value_factor:用文档中的某个字段值作为函数结果
random_score:随机生成一个值作为函数结果
script_score:自定义计算公式,公式结果为函数结果
[加权模式]
multiply:两者相乘(默认)
replace:使用算分函数结果替换原有关联度打分(query score)
sum/avg/max/min:求和/求平均/取最大值/取最小值
3.布尔组合查询
布尔查询时一个或多个子查询的组合,子查询的组合方式有如下几种:
- must:必须匹配每个子查询,类似"与"
- should:选择性匹配每个子查询,类似"或"
- must_not:必须不匹配,不参与分数计算,类似"非"
- filter:必须匹配,不参与分数计算
GET /hotel/ _ search
"query": {
  "bool": {
    "must": [  # city属性为:上海
      {"term": {"city": "上海" }},
    ],
    "should": [  # brand属性为:皇冠假日 或 华美达
      {"term": {"brand": "皇冠假日"}},
      {"term": {"brana": "华美达"}}
    ],
    "must_not": [  # price>500 (price不能小于等于500)
      { "range": { "price": { "lte": 500 } }}
    ],
    "filter": [  # score>45
      { "range": {"score": { "gte": 45 } }}
    ]
  }
}
四、搜索结果处理
1.排序
elasticsearch支持对搜索结果排序,默认是根据相关度算分(_ score) 来排序。可以排序字段类型有: keyword类型 、数值类型、地理坐标类型、日期类型等。
GET /indexName/_search
{
  "query": {
    "match_all": {}
  },
  "sort": [{
      "FIELD": "desc"//排序字段和排序方式ASC、DESC
    }]
}GET /indexName/_search
{
"query": {
"match_all": {}
},
"sort": [{
"_geo_distance" : {
"FIELD" : "纬度,经度", #另一种写法:{"lat":纬度,"lon":经度}
"order" : "asc",
"unit" : "km"
}
}]
}2.分页
GET /indexName/_search
{
  "query": {
    "查询类型": {
      "查询条件": "查询值"
    }
  },
  "from": 0,  #分页开始的索引,默认为0
  "size": 10  #一次获取的文档总数
}
深度搜索问题
ES原生支持分布式,会面临深度搜索问题,其查询过程如下:
- 首先在每个分片上都排序查询对应要查询的前若干条文档
- 将所有的查询结果进行聚合,在内存中重新排序选出前若干条文档
- 从该若干条结果中选取需要的对应部分结果
如果搜索页数过深,结果集越大,对内存与CPU消耗也越高,因此ES设定结果集的查询上限是10000
深度搜索问题解决方案
- search after:从上一次的排序值开始,查询下一页的数据,但只能向后逐页查询,不支持随机翻页
- scroll:将排序数据形成快照保存在内存,会有额外内存消耗,且搜索结果非实时(官方已不推荐使用)
3.高亮
GET /indexName/_search
{
  "query": {
    "match": {
      "FIELD": "TEXT"
    }
  },
  "hightlight": {
    "fields": {
      "FIELD": {  #指定高亮的字段
        "pre_tags": "<em>",  # 用于标记高亮字段的前置标签
        "post_tags": "</em>",  # 用于标记高亮字段的后置标签
        "require_field_match": "false"  #允许搜索字段与高亮字段不一致,默认必须一致才有效果
      }
    }
  }
}
一、聚合
1.聚合的分类
- 桶(Bucket)聚合:用于对文档做分组,常见的有如下几种:
- TermAggregation:按照文档字段值分组
- Date Histogram:按照日期阶梯分组,如一周为一组或一月为一组
- 度量(Metric)聚合:用于计算一些数值,常见的有如下几种:
- Avg/Max/Min:求平均值/最大值/最小值
- Stats:同时求max、min、avg、sum等
- 管道(pipeline)聚合:以其他聚合的结果为基础做聚合
2.实现聚合
GET /indexName/_search
{
  "query": {  # 此处可用查询限定聚合范围,如下例
    "range": {
      "price": {
        "lte": 200  # 对price<200的文档聚合
      }
    }
  }
  "size": 0,  # 设置size为0,结果中不包含文档,只包含聚合结果
  "aggs": {  # 定义聚合
    "brandAgg": {  # 聚合名称
      "terms": {  # 聚合类型,按照品牌值聚合,所以选择terms
        "field": "brand",  # 参与聚合的字段
        "order": {  # 设置聚合结果排序
          "_count": "asc"  # 按照 _count字段(聚合文档数量) 升序排列
        },
        "size": 20  # 希望获取的聚合结果的数量
      }
    }
  }
}GET /indexName/_search
{
"size": 0, # 设置size为0,结果中不包含文档,只包含聚合结果
"aggs": { # 定义聚合
"brandAgg": { # 聚合名称
"terms": { # 聚合类型,按照品牌值聚合,所以选择terms
"field": "brand", # 参与聚合的字段
"size": 20 # 希望获取的聚合结果的数量
},
"aggs": {
"score_stats": { # 子聚合,分组后对结果进行统计
"stats": { # 聚合类型
"field": "score" # 聚合字段
}
}
}
}
}
}二、拼音自动补全
1.安装自动补全分词器
Github地址:下载地址
安装流程:
- 下载对应版本插件,解压
- 上传到ElasticSearch的plugin目录,重启ElasticSearch
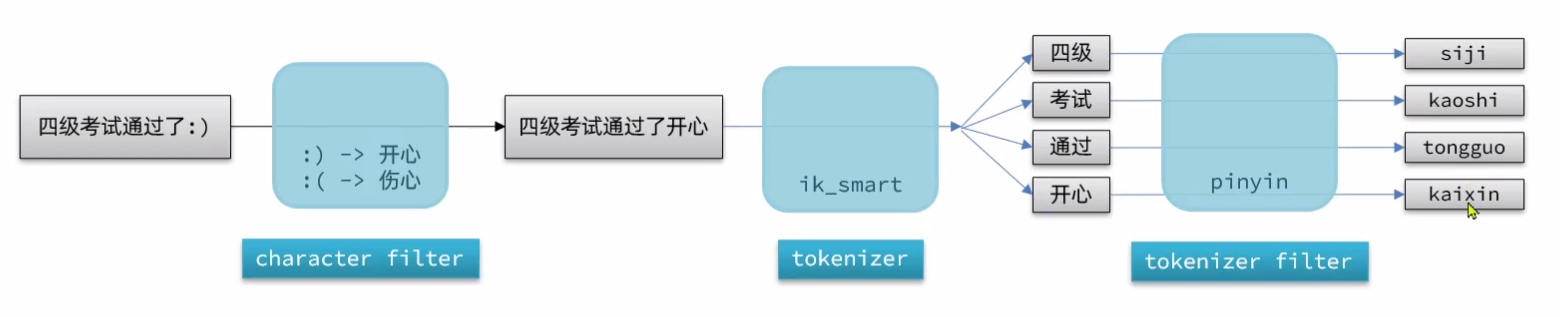
2.分词器的组成
- character filters:在tokenizer之前对文本进行处理,例如删除字符、替换字符
- tokenizer:将文本按照一定的规则切割成词条(term) ,例如keyword,就是不分词;还有ik_ smart
- tokenizer filter:将tokenizer输出的词条做进一步处理,例如大小写转换、同义词处理、拼音处理等
3.自定义分词器
PUT /test
{
  "settings": {
    "analysis": {
      "analyzer": { //自定义分词器
        "my_analyzer": { // 分词器名称
          "tokenizer": "ik_max_word",
          "filter": "py"
        }
      },
      "filter": { //自定义tokenizer filter
        "py": { //过滤器名称
          "type": "pinyin",  //过滤器类型,这里指定的是pinyin
          "keep_full_ pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  mapping: {
    "properties": {
      "name": {
        "type": "text",
        "analyzer": "my_analyzer",  # 创建索引时使用分词器
        "search_analyzer": "ik_smart"  # 指定搜索时使用的分词器
      }
    }
  }
}
注意:拼音分词器适合在创建倒排索引的时候使用,但不能在搜索的时候使用(会造成同音词混淆)。
4.自动补全实现
为了提高补全查询的效率,对于文档中的字段的类型有一些约束:
- 参与补全查询的字段必须是completion类型
- 字段的内容一般是用来补全的多个词条形成的数组
GET /test/_search
{
  "suggest": {
    "title_suggest": {
      "text": "s",  # 查询关键字
      "completion": {
        "field": "title,  # 补全查询的字段
        "skip_duplicates": true,  # 跳过重复的
        "size": 10  # 获取前10条结果
      }
    }
  }
}