第三章 Spark入门基础 v1.0
第一部分 Spark简介
一、基本组件
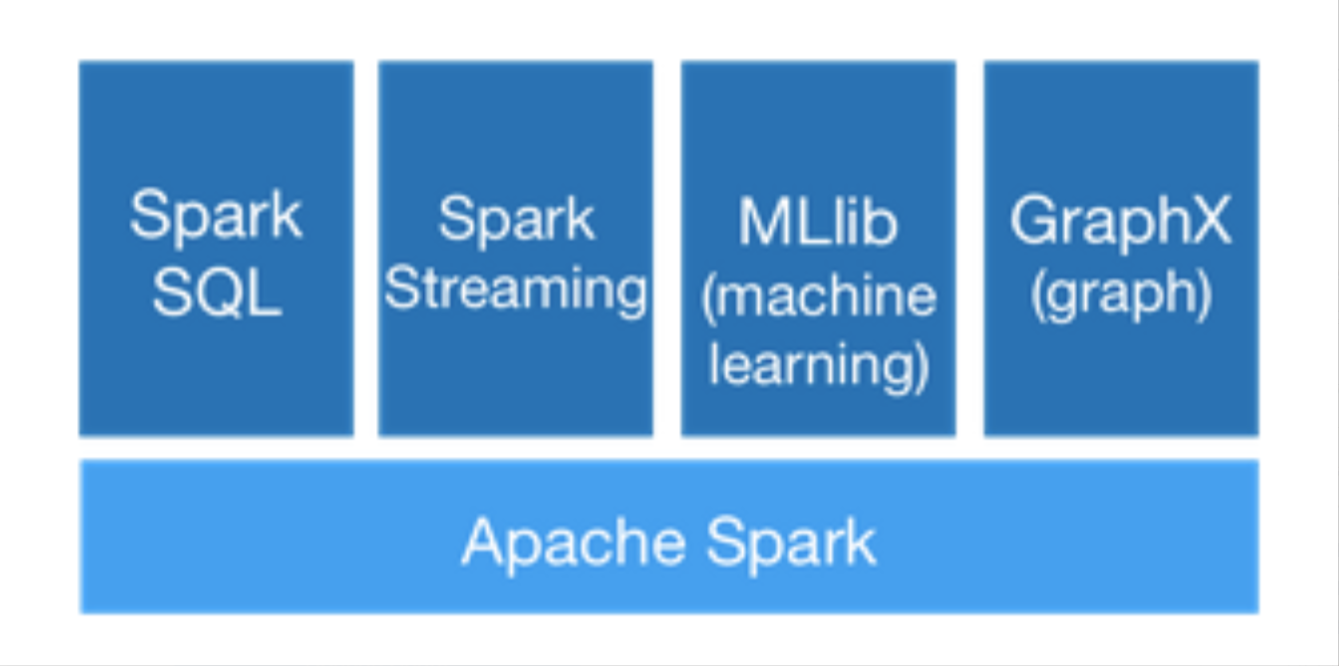
1.Spark Core
实现了 Spark 的基本功能,包含任务调度、内存管理、错误恢复、与存储系统 交互等模块。Spark Core 中还包含了对弹性分布式数据集(resilient distributed dataset,简称RDD)的 API 定义。
2.Spark SQL
是 Spark 用来操作结构化数据的程序包。通过 Spark SQL,我们可以使用 SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。Spark SQL 支持多种数据源,比 如 Hive 表、Parquet 以及 JSON 等。
3.Spark Streaming
是 Spark 提供的对实时数据进行流式计算的组件。提供了用来操作数据流的 API,并且与 Spark Core 中的 RDD API 高度对应。
4.Spark MLlib
提供常见的机器学习(ML)功能的程序库。包括分类、回归、聚类、协同过滤等,还提供了模型评估、数据 导入等额外的支持功能。
5.Spark GraphX
GraphX在Spark基础上提供了一站式的数据解决方案,可以高效地完成图计算的完整流水作业。GraphX是用于图计算和并行图计算的新的(alpha)Spark API。通过引入弹性分布式属性图(Resilient Distributed Property Graph),一种顶点和边都带有属性的有向多重图,扩展了Spark RDD。
6.Structured Streaming(2.X版本)
结构化流是构建在sparksql引擎上的可伸缩且容错的流处理引擎。在内部,默认情况下,结构化流式处理查询使用微批处理引擎进行处理,该引擎将数据流作为一系列小批处理作业进行处理,从而实现低至100毫秒的端到端延迟,并且只保证一次容错。
二、核心概念
| 概念 | 说明 |
|---|---|
| RDD | 弹性分布式数据集,Spark的基本数据抽象 |
| DAG | 有向无环图,Spark任务的执行计划 |
| Executor | 运行在工作节点上的进程,负责执行任务 |
| Driver | 用户提交的应用程序,负责创建SparkContext |
| Application | 用户提交的应用程序 |
| Job | 由多个Task组成的并行计算任务 |
| Stage | Job被划分的阶段,由多个Task组成 |
| Task | 被发送到Executor上的最小工作单元 |
三、运行模式
| 模式 | 说明 |
|---|---|
| Local | 本地模式,单机运行,用于开发测试 |
| Standalone | Spark自带的集群管理器 |
| YARN | Hadoop YARN集群管理器(常用) |
| Mesos | Apache Mesos集群管理器 |
| Kubernetes | K8s集群管理器 |
第二部分 Spark安装
一、Local模式安装
1.前置环境
确保已安装JDK 8和Scala(Spark 3.x自带Scala,可不单独安装)
2.下载并解压
bash
# 下载Spark
wget https://archive.apache.org/dist/spark/spark-3.3.2/spark-3.3.2-bin-hadoop3.tgz

# 解压
tar -zxvf spark-3.3.2-bin-hadoop3.tgz -C /usr/local/
mv /usr/local/spark-3.3.2-bin-hadoop3 /usr/local/spark
3.配置环境变量
bash
vi /etc/profile

### 添加内容 ###
export SPARK_HOME=/usr/local/spark
export PATH=${SPARK_HOME}/bin:$PATH

### 刷新 ###
source /etc/profile
4.验证安装
bash
# 启动spark-shell
spark-shell
进入Scala交互式界面即表示安装成功~
scala
scala> val data = List(1, 2, 3, 4, 5)
scala> sc.parallelize(data).map(_ * 2).collect()
// Array(2, 4, 6, 8, 10)
二、IDEA环境配置
1.Maven依赖
xml
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-core_2.12</artifactId>
    <version>3.3.2</version>
</dependency>

<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-sql_2.12</artifactId>
    <version>3.3.2</version>
</dependency>
2.WordCount示例
java
import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import java.util.Arrays;

public class SparkWordCount {
    public static void main(String[] args) {
        // 创建Spark配置
        SparkConf conf = new SparkConf()
            .setAppName("WordCount")
            .setMaster("local[*]");

        // 创建SparkContext
        JavaSparkContext sc = new JavaSparkContext(conf);

        // 读取文本文件
        JavaRDD<String> lines = sc.textFile("input.txt");

        // 统计词频
        lines.flatMap(line -> Arrays.asList(line.split(" ")).iterator())
             .mapToPair(word -> new scala.Tuple2<>(word, 1))
             .reduceByKey(Integer::sum)
             .collect()
             .forEach(System.out::println);

        sc.close();
    }
}