第五章 集合类型 v1.0
第一部分 集合类
使用实用工具类库:import java.util.<类名>;
一、Collection类
1.概述图
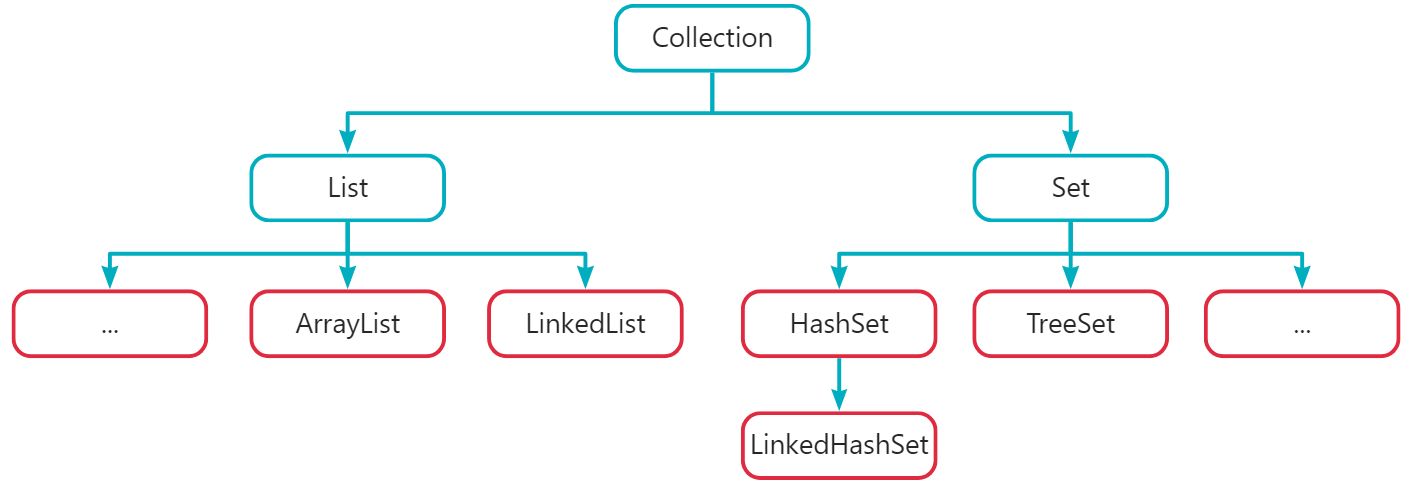
2.List类
a.特点
有序、可重复、有索引
b.常见实现类
ArrayList:底层是基于数组实现的,根据查询元素快,增删相对慢。
LinkedList:底层基于双链表实现的,查询元素慢,增删首尾元素是非常快的。
c.常用方法
| 方法 | 作用 |
|---|---|
| list.add(x) | 将新对象添加到列表 |
| list.remove(x) | 从列表中移除匹配的第一个对象 |
| list.remove(idx) | 删除指定索引处的元素,返回被删除的元素 |
| list.contains(x) | 如果列表包含指定的元素,则返回true, 否则返回false |
| list.get(idx) | 返回列表中指定位置的元素 |
| list.size() | 返回列表中元素的数量 |
| list.clear() | 删除列表中所有元素 |
3.Set类
a.特点
无序列、不重复、无索引
b.常见实现类
HashSet:无序、不重复、无索引
LinkedHashSet:有序、不重复、无索引
TreeSet:排序(默认升序排列)、不重复、无索引
c.常用方法
| 方法 | 作用 |
|---|---|
| set.add(x) | 将新对象添加到集合 |
| set.remove(x) | 从集合中移除匹配的第一个对象 |
| set.contains(x) | 如果集合包含指定的元素,则返回true, 否则返回false |
| set.size() | 返回集合中元素的数量 |
| set.clear() | 删除集合中所有元素 |
二、Map类
1.概念图
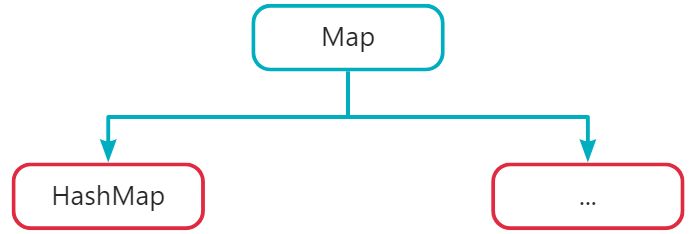
2.基本概念
Map集合是一种双列集合,每个元素包含两个数据,每个元素的格式:key=value,又被称为键值对集合。
3.常用方法
| 方法 | 作用 |
|---|---|
| map.put(key,value) | 向Map中添加值 |
| map.remove(key,value) | 删除Map中的值 |
| map.clear() | 移除所有键值对元素 |
| map.get(key) | 访问Map中的值 |
| map.containKey(key) | 确定是否存在指定的键,存在返回true,如果不存在返回null值 |
| map.containValue(value) | 确定是否存在指定的值,存在返回true,如果不存在返回null值 |
| map.isEmpty() | 判断集合是否为空 |
| map.size() | 得到集合的长度 |
| map.putAll(otherMap) | 将另一个键值对中的所有元素放置(覆盖)到当前键值对中 |
| map.entrySet() | 返回键值对的Entry集合 |
| map.keySet() | 返回键值对的Key集合 |
3.常见实现类
- HashMap:键(Key)元素无序,不重复,无索引,值(Value)元素不做要求。
- LinkedHashMap:键(Key)元素有序,不重复,无索引,值(Value)元素不做要求。
- TreeMap:元素按照键(Key)排序,不重复,无索引,值(Value)元素不做要求。
4.Map集合的遍历
- 方式1
先获取Map集合的全部键的Set集合:key = map.keySet();
遍历键的Set集合,然后通过键提取对应值:value = map.get(key);
Set<String> keys = map.keySet();
//开始遍历
for (String key : keys) {
    int value = map.get(key);
}- 方式2
先把Map集合转换成Set集合,此时Set集合中每个元素为键值对实体类型:map.entrySet();
再遍历Set集合,然后提取键以及提取值。
Set<Map.Entry<String,Integer>> entries = map.entrySet();
//开始遍历
for(Map. Entry<String,Integer> entry : entries) {
    String key = entry.getKey();
    int value = entry.getValue();
}- 方式3(Lambda表达式)
使用Lambda表达式结合Map类型的forEach()方法
maps.forEach((k, v) -> {
    System.out.println(k + ":" + v);
});三、Collections(集合工具类)
1.作用
Collections类中具有一系列用于处理集合数据的静态方法帮助处理不同集合类型数据
2.常用方法
| 方法 | 作用 |
|---|---|
| Collections.addAll(collection,..) | 添加所有对象进入集合中 |
| Collections.sort(collection) | 对集合类型对象中的元素进行排序 |
| Collections.max(collection) | 返回由自然顺序决定的集合中的最大元素 |
| Collections.min(collection) | 返回由自然顺序决定的集合中的最小元素 |
| Collections.reverse(collection) | 反转列表中的序列 |
| Collections.shuffle(collection) | 将列表中的元素随机排序 |
四、Iterator(迭代器)
1.特征
迭代器是一个能够循环访问,获取或删除元素的对象。在通过迭代器访问集合之前,你必须先获得一个集合。每个集合类都提供了一个iterator()方法,它将一个迭代器返回到集合的开始处。通过使用这个迭代器对象,你可以访问集合中的每个元素,一次一个元素。
2.创建对象
Iterator<泛型>对象名 = new collection.iterator();3.常用方法
| 方法 | 作用 |
|---|---|
| iterator.hasNext() | 检查序列中是否还有元素。若还有元素返回true;否则返回false。 |
| iterator.next() | 获得序列中的下一个元素 |
| iterator.remove() | 将迭代器新返回的元素删除 |
五、集合类的遍历
1.常用的遍历方式
- 使用迭代器遍历
- for-each循环遍历
- Lambda表达式遍历(原理是集合类对象的forEach()方法)
2.Lambda表达式遍历
arr.forEach(s->{
    System.out.println(s);
})
第二部分 集合类的常见实现类
一、List类的实现类
1.ArrayList(顺序表)
a.特征
使用初始大小创建的可以自动增大或缩小的数组类,与普通数组非常相似,更适合随机存取数据
b.创建对象
List 对象名 = new ArrayList(初始大小);
List<数据类型>对象名 = new ArrayList<数据类型>(初始大小);
List<数据类型>对象名 = new ArrayList<>(初始大小); //JDK1.7起支持注:ArrayList<数据类型>为泛型类,在编译阶段约束集合对象只能操作某种数据类型。
c.初始化与扩容机制
jdk1.7:默认初始容量为10,默认加载因子为1,扩容后大小为原容量的1.5倍
jdk1.8:默认为空,初始化(添加元素)时初始化容量为10,默认加载因子为1,扩容后大小为原容量的1.5倍
*加载因子:数组触发扩容机制时元素占容量大小的百分比,如加载因子为1时数组满才扩容
2.LinkedList(链表)
a.特征
与ArrayList基本一致,但不能为LinkedList指定初始容量,主要区别在于储存对象的方式为双向链表
b.创建对象
List<数据类型>对象名 = new LinkedList<数据类型>();3.Vector
a.特征
线程安全,但速度慢,底层类似ArrayList
b.创建对象
List 对象名 = new Vector(初始大小);
List<数据类型>对象名 = new Vector<数据类型>(初始大小);
List<数据类型>对象名 = new Vector<>(初始大小);   //JDK1.7起支持
c.初始化与扩容机制
jdk1.7/1.8:默认初始容量为10,默认加载因子为1,扩容后大小为原容量的2倍
二、Set类的实现类
1.HashSet
a.特征
不能包含重复元素的集合,模拟数学集抽象,其中一个实现是HashSet,底层结构为不展示Value值HashMap
b.创建对象
Set<数据类型> 对象名 = new HashSet<>();*HashSet类不会自动保留添加元素的顺序。若要对元素进行排序,可以使用LinkedHashSet,它按照它们插入的顺序来维护集合元素的链接列表。
c.HashSet去重原理
先判断元素的哈希值,再判断equals
如果对象集合需要去除重复值,需要重写hashCode()方法和equals()方法
@Override
public int hashCode() {
    return Objects.hash(<比较参数列表>);
}
2.LinkedHashSet
a.特征
底层结构依然为HashSet,在此基础上每个元素多添加一个双链表机制存储记录顺序
b.创建对象
Set<数据类型> 对象名 = new LinkedHashSet<>();3.TreeSet
a.特征
底层基于红黑树数据结构进行排序,可以将元素按照指定的规则进行排序,底层通过TreeMap实现
b.自定义排序规则
对于自定义类型的对象需要指定规则(返回值正负)排序,并且按照排序规则中值是否为0进行去重。
- 方式1:自定义类实现Comparable接口中的compareTo()方法
@Override
public int compareTo(自定义变量类型 o) {
    //使用此种方法可以保留重复的元素
    return this.value - o.value >= 0 ? 1 : -1;
}- 方式2:使用集合自带比较器对象进行规则定制(优先使用)
@Override
public int compareTo(自定义变量类型 o) {
    //使用此种方法可以保留重复的元素
    return Double.compare(this.getPrice(), o.getPrice());
}
三、Map类的实现类
1.HashMap(哈希表)
a.特征
用于将数据集合以键值对的形式存储
b.创建对象
Map<键数据类型,值数据类型> 对象名 = new HashMap<>();c.扩容机制
jdk1.7:使用数组+链表实现,初始大小为16,加载因子为0.75,扩容后大小为原容量的2倍
| 元素数量 | 容量 | 操作 |
|---|---|---|
| 1-12 | 16 | 正常插入 |
| 13 | 16 | 触发扩容 → 容量变为32 |
| 14-24 | 32 | 正常插入 |
| 25 | 32 | 触发扩容 → 容量变为64 |
jdk1.8:使用数组+链表+红黑树实现,初始大小为16,加载因子为0.75,扩容后大小为原容量的2倍,当一条链表的元素达到8个且table数组的大小达到64,链表就转成红黑树,如果table数组未到64,table数组将扩容至原来的2倍,直至大小达到64链表转成红黑树为止。
| 元素数量 | 容量 | 最长链表长度 | 操作 |
|---|---|---|---|
| 1-12 | 16 | ≤8 | 正常插入 |
| 13 | 16 | - | 触发扩容 → 容量变为32 |
| 14-24 | 32 | ≤8 | 正常插入 |
| 25 | 32 | - | 触发扩容 → 容量变为64 |
| - | 64 | 8 | 链表转红黑树 |
2.LinkedHashMap(有序哈希表)
a.特征
LinkedHashMap通过在HashMap的基础上添加链表指针实现,插入是有序的(按插入顺序)
b.具体应用
实现LRU缓存淘汰算法,应用了LinkedHashMap的存储的顺序和添加的顺序是一样的特性
3.TreeMap
底层基于红黑树数据结构进行排序,可以将键按照指定的规则进行排序
4.ConcurrentHashMap
ConcurrentHashMap是一个线程安全的、高性能的哈希表,它支持并发访问和修改操作。它使用分段锁来实现线程安全,并且可以在高并发场景下提供高效的性能。
5.Hashtable
Hashtable也是线程安全的哈希表,通过给每个方法都用synchronized关键字进行加锁来保证线程安全。
但整个哈希表只有一把锁,当有多个线程竞争锁的时候,只有一个线程拿到锁,其他九个线程就需要阻塞等待,这会导致整个效率比较低效,故使用ConcurrentHashMap这样的线程安全的哈希表更好。
扩容机制
默认初始容量为11,线程安全,但是速度慢,不允许key/value为null。
加载因子为0.75:当元素个数超过容量长度的0.75倍时,进行扩容。
扩容增量:2*原数组长度+1,如 Hashtable的容量为11,一次扩容后是容量为23。
